面向科学发现的演化式 AI 系统
本文主要梳理 FunSearch、AlphaEvolve 与 Escher-Loop 三项工作。
假设我们已经拥有一个能够提出科学假设、阅读文献、编写模拟代码、设计实验并分析结果的 AI 系统。我们是否只需输入一个研究问题,就能期待它一次性给出真正新颖的科学发现?
恐怕没有这么简单。科学发现很少诞生于单次“生成”,它更像一个不断循环的过程:
- 提出候选方案或假设;
- 评估与检验;
- 找出问题;
- 修改方案;
- 再次检验。
这与演化搜索的结构高度一致。因此,面向科学发现的 AI 不只是让一个更强的模型直接吐出答案,而是要把大语言模型或智能体、工具、评估器、外部记忆和资源调度组织成一个能够长期搜索、积累知识并持续改进的系统。
本文是英文原文的中文译写版。核心公式、系统结构与论点保持一致,少量重复描述被合并,以便中文阅读更加连贯。
从优化走向搜索
Richard Sutton 在“苦涩的教训”中强调:随着计算量增加,最能够持续扩展的通用方法是搜索与学习。
把科学问题的求解写成
其中 \(\mathcal X\) 是所有候选解的集合,\(R(x)\) 是评价解质量的函数。从优化角度看,这就是在巨大空间中寻找评价最高的候选方案。
但与神经网络参数优化不同,程序空间通常是离散且结构复杂的。比如把
def heuristic(x):
    return x.size
改成
def heuristic(x):
    return x.size ** 2
代码只变了一点,行为却可能发生巨大变化。程序空间缺少可以直接利用的连续局部结构,无法像参数优化那样依赖梯度。
好消息是,对任意候选程序,我们通常都能:
- 生成程序;
- 执行程序;
- 检查约束与正确性;
- 按任务指标计算分数。
这类问题可以概括为“求解困难,但评估容易”。自然的办法就是不断生成新候选,用评估函数筛选更好的候选,再重复这一过程。
演化搜索
演化搜索是一种基于种群的随机搜索方法,通过选择、变异、重组、评估和淘汰,不断产生更好的候选解。示例代码见 Google Colab。
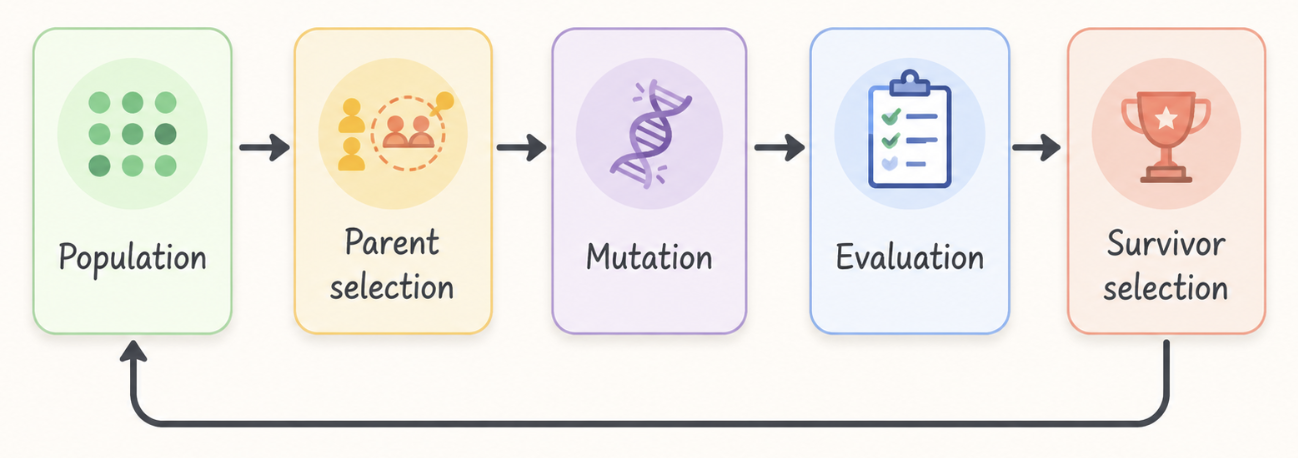
设第 \(t\) 代种群为
每个候选 \(x_t^{(i)}\) 称为一个个体。
第一步是从当前种群中选择值得继续探索的父代:
衡量个体质量的指标称为适应度(fitness),对应前面的 \(R\)。常见方法是锦标赛选择:随机抽取 \(k\) 个个体,以最高概率选最优者、较低概率选次优者。这样既偏向高质量候选,又不会完全丢失多样性。
这里存在探索与利用的权衡:
- 选择压力过强时,搜索会退化成一条贪心轨迹,收敛快但容易陷入局部最优;
- 选择压力过弱时,种群多样性丰富,却会把大量计算浪费在低质量候选上。
第二步是变异:
程序本身可以视为基因型,运行产生的行为或输出则是表现型。在基于 LLM 的程序搜索中,变异可能是修改表达式、重写关键函数、修复错误或调整算法结构。若把多个父代的优点组合起来生成后代,则称为交叉(crossover)。
第三步评估后代:
最后让父代与后代共同竞争,形成下一代:
保留历史最优个体不被新一代意外淘汰的机制称为精英保留。
通用框架
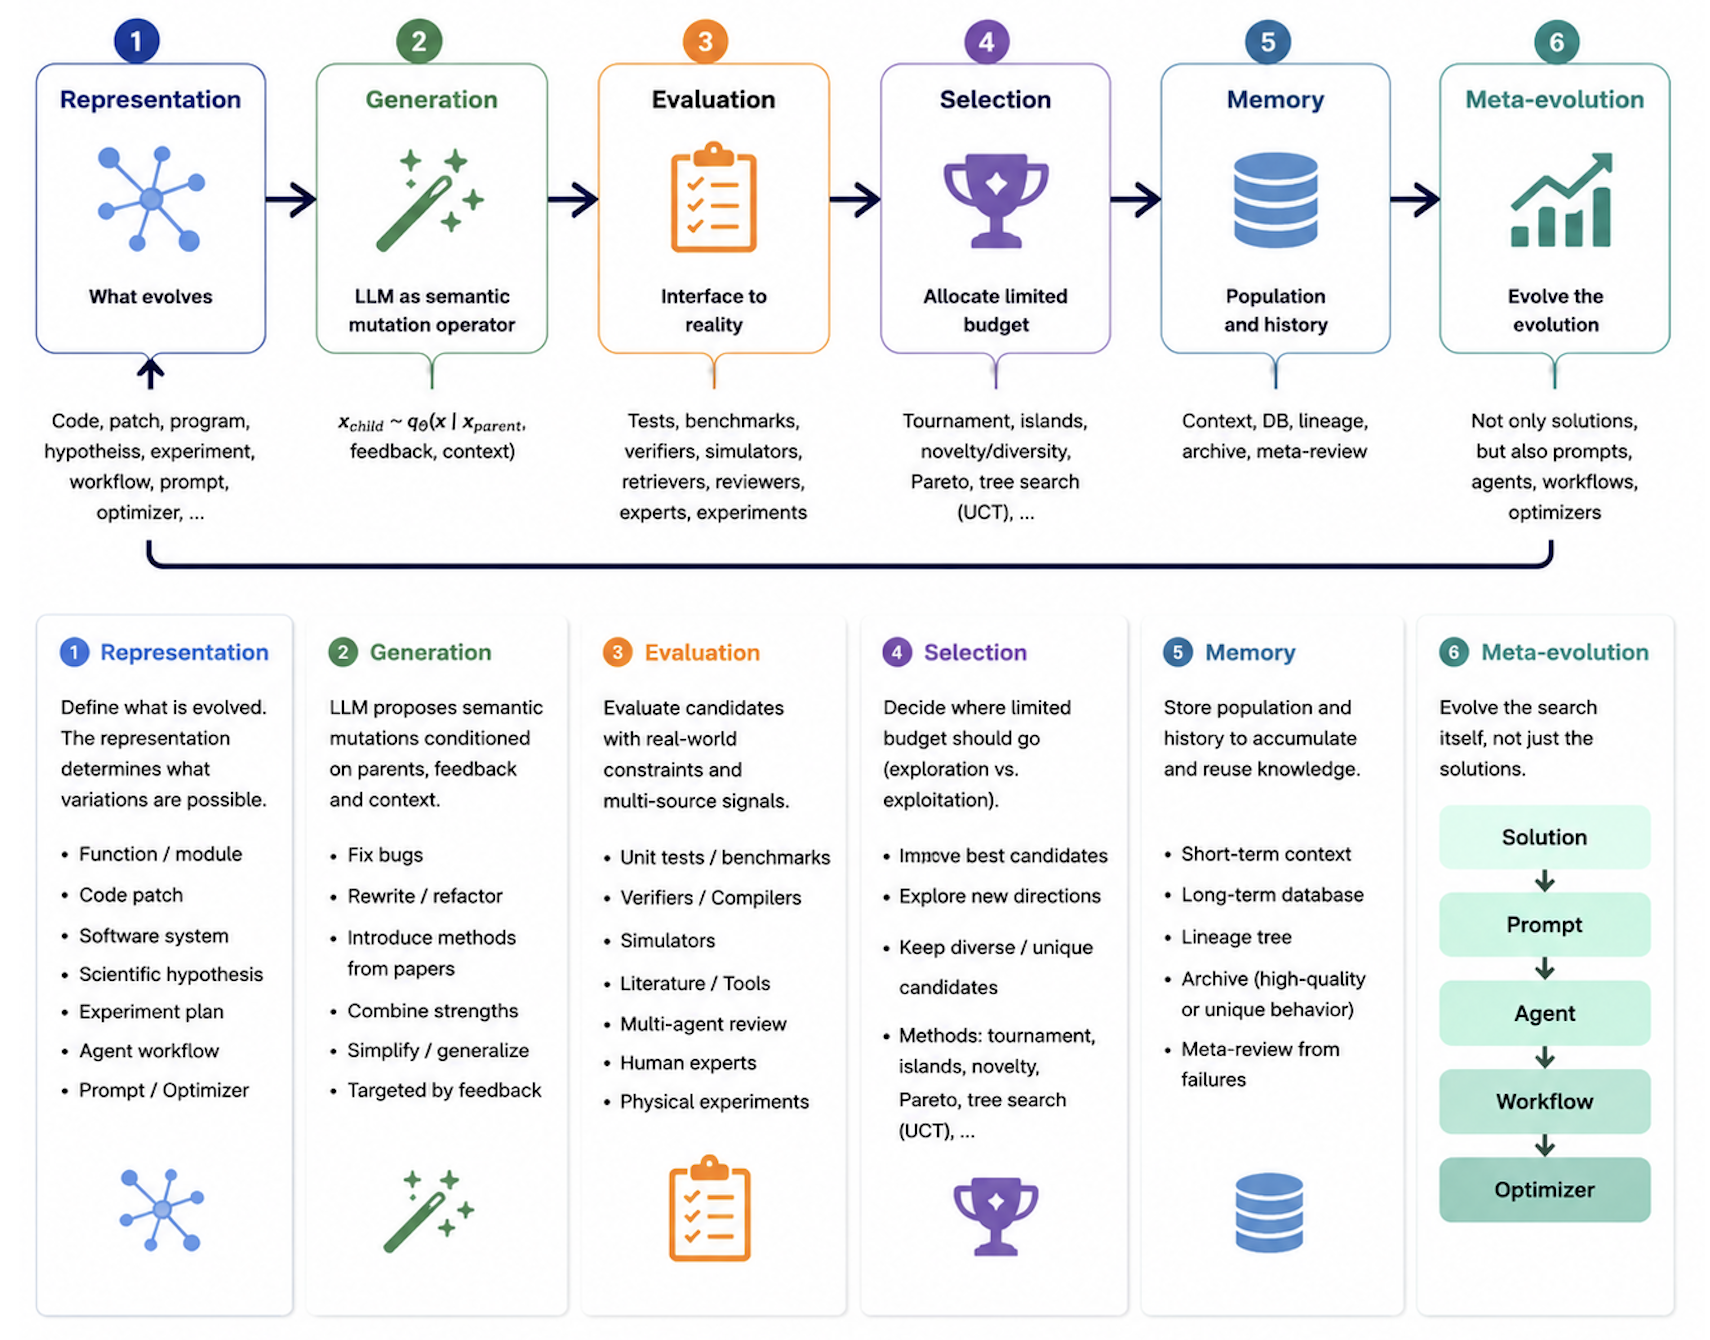
FunSearch
在 FunSearch 中,搜索对象是一个把问题输入 \(z\) 映射为解 \(x\) 的函数:
其中 \(\mathcal P\) 是程序空间。
FunSearch 通常不允许模型修改整个软件系统,而只让它演化一个关键函数。把固定程序框架记为 \(S\),可修改函数记为 \(f\),完整程序就是 \(S[f]\)。
设评估输入集合为
候选函数 \(f\) 在输入 \(z_i\) 上的得分为
再通过聚合函数得到总分:
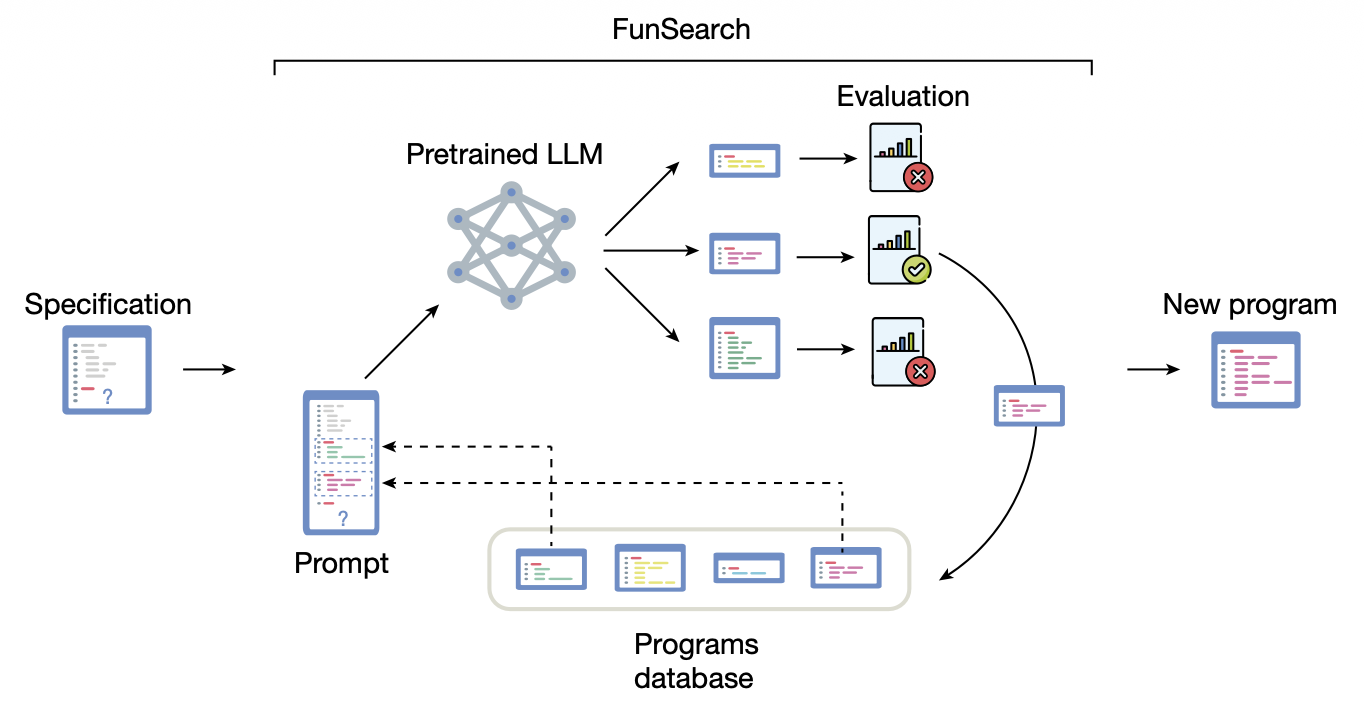
任务规范与评估器
任务规范定义:
- 可修改函数的名称、输入输出类型和自然语言说明;
- 固定的求解框架;
- 评估器与初始实现;
- 可使用的库和辅助函数。
评估器从三个层面检查候选程序:
- 语法有效性:代码能否被编译器或解释器解析;
- 执行有效性:能否在时间、内存限制内终止,且不抛出异常;
- 输出正确性与质量:是否满足约束,以及任务得分有多高。
程序数据库
程序数据库持久化保存有效候选、各测试输入上的得分、聚合得分以及所属种群。它相当于搜索系统的外部记忆。
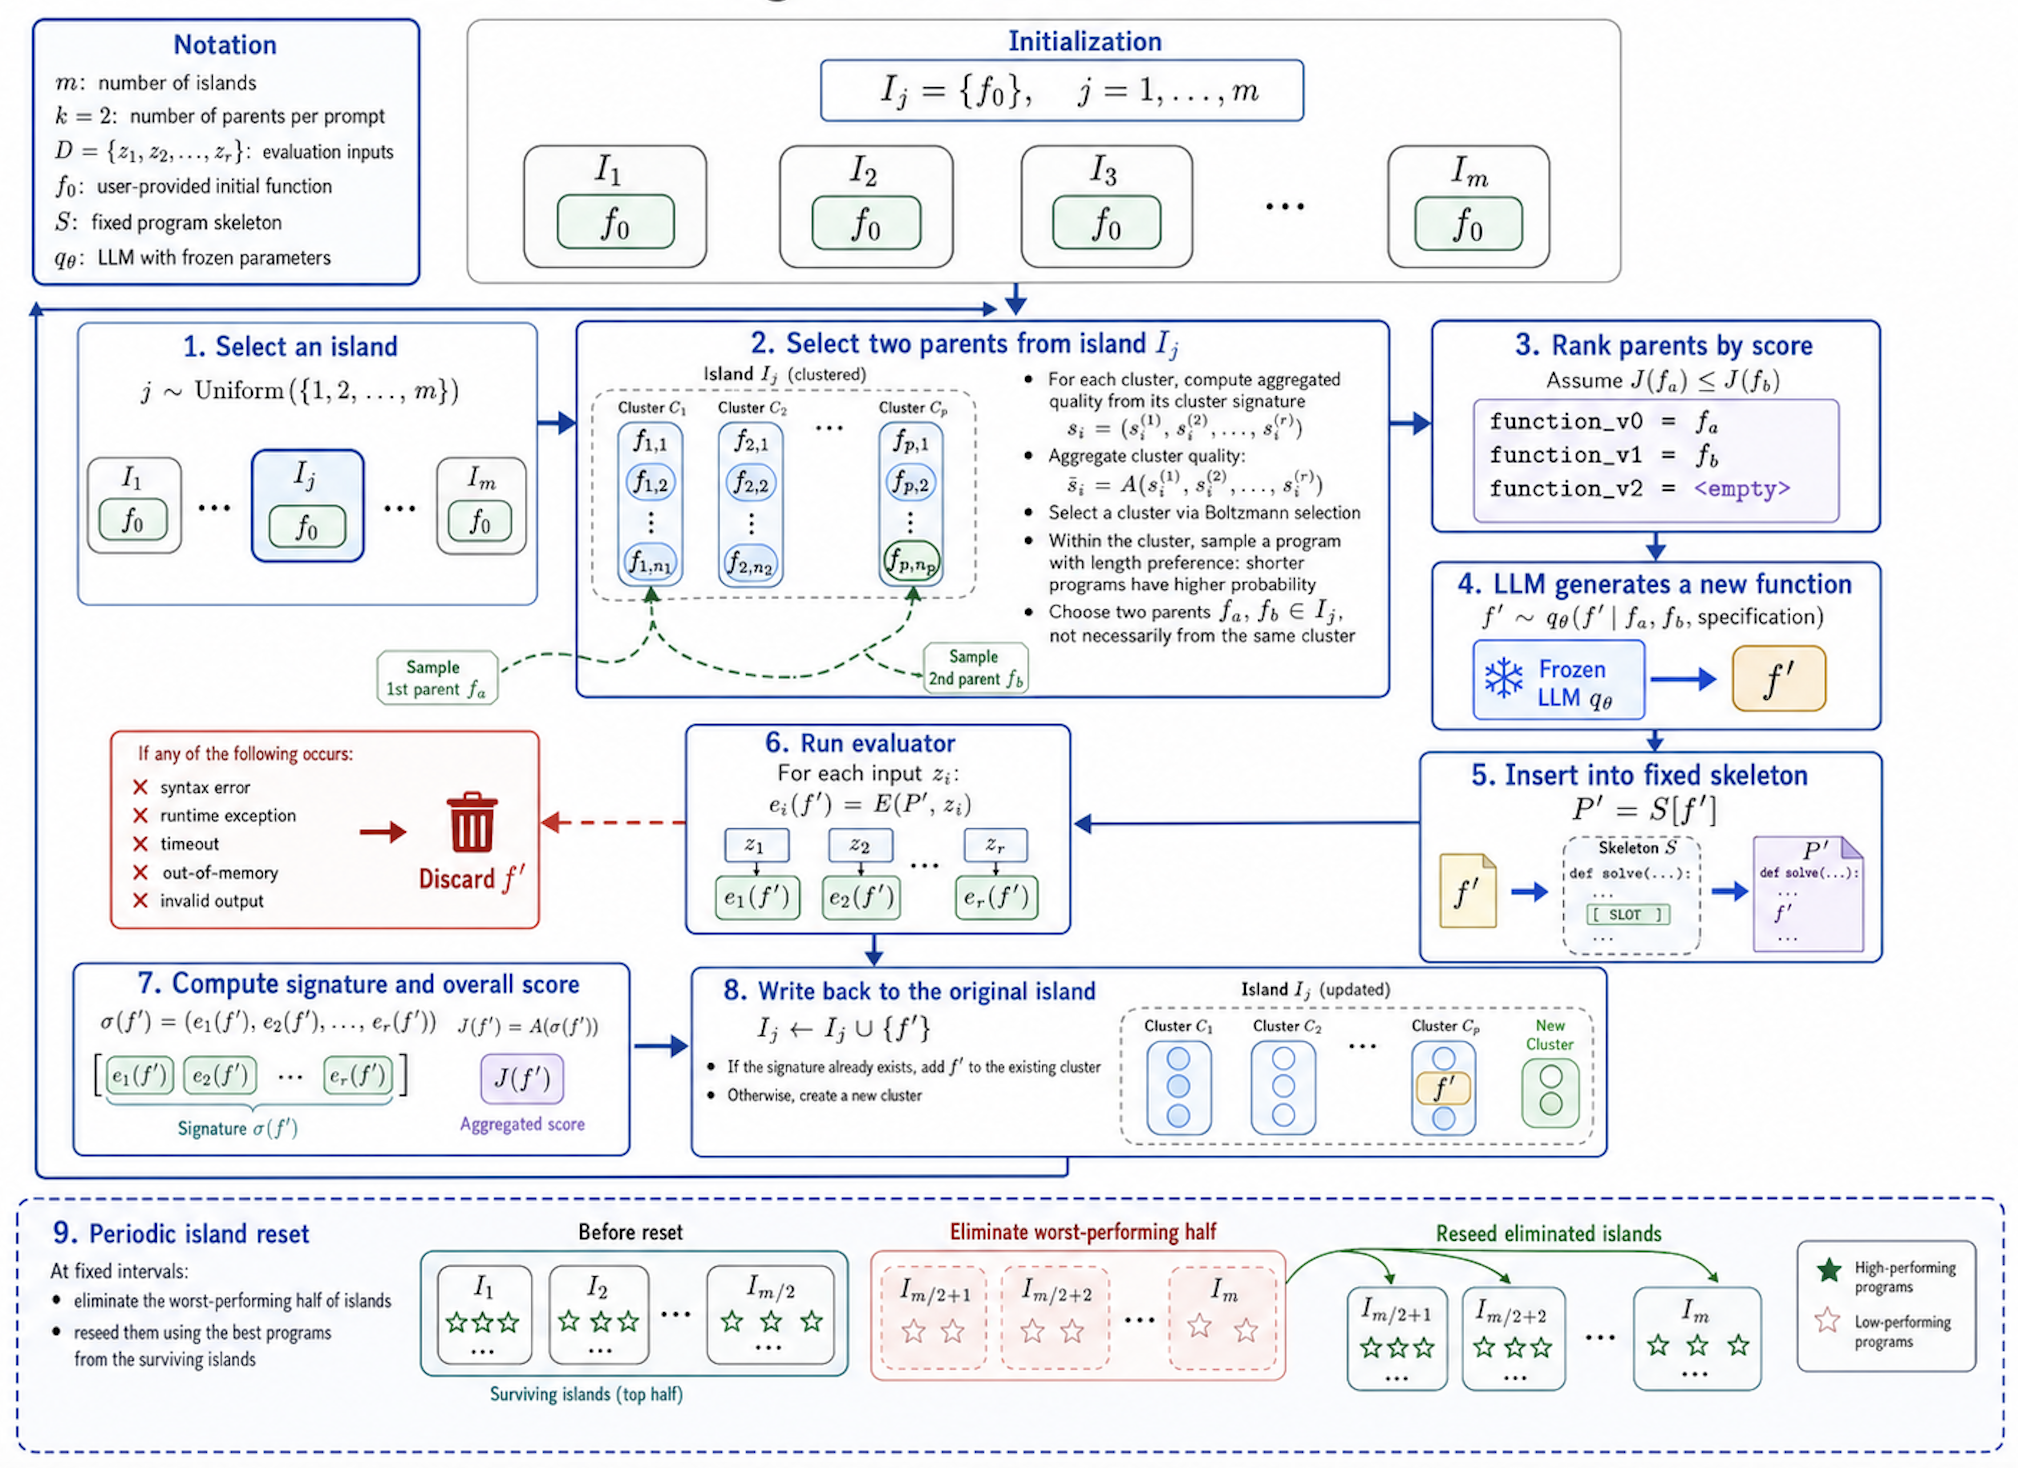
岛屿模型
FunSearch 把总种群划分成多个相对独立的子种群,也就是“岛屿”:
每个岛从相同的初始程序 \(f_0\) 出发,之后独立演化。构造提示词时,系统随机选一个岛,只从该岛选择父代,并把新程序评估后放回同一岛。
每隔一段时间,系统比较各岛的最佳得分
清空表现最差的一半岛屿,再从幸存岛屿复制最佳程序作为新的起点。这样既保留多个搜索方向,又会周期性传播成功经验。
签名聚类
候选程序在各评估输入上的得分向量称为签名:
签名相同的程序被分到同一簇。选定岛屿后,FunSearch 先用 Boltzmann 分布选择簇:
其中 \(\bar s_i\) 是簇的聚合质量。温度 \(T\) 大时分布更均匀,偏向探索;\(T\) 小时概率集中在高分候选上,偏向利用。
选定簇后,系统还会偏好较短的程序:
较短的程序通常更容易理解,也更不容易积累无关修改。
提示词构造
FunSearch 并非只把“当前最佳程序”交给 LLM,而是选择多个历史程序,按得分从低到高排列:
def priority_v0(x):
    # 较低得分的实现
    ...

def priority_v1(x):
    # 较高得分的实现
    ...

def priority_v2(x):
    # TODO: 生成更好的版本
这称为 best-shot prompting。单个最佳程序只提供一个静态点,而一对质量不同的程序还能隐式表达改进方向
为模型提供“下一步该往哪里改”的语义线索。
AlphaEvolve
AlphaEvolve 可以看作 FunSearch 的大规模、通用化扩展:
| FunSearch | AlphaEvolve |
|---|---|
| 修改一个关键函数 | 修改多个代码块 |
| 单一得分 | 多指标评估 |
| 重新生成完整函数 | 结构化补丁 |
| 固定提示词 | 丰富的历史、反馈与领域上下文 |
| 单层评估 | 级联评估 |
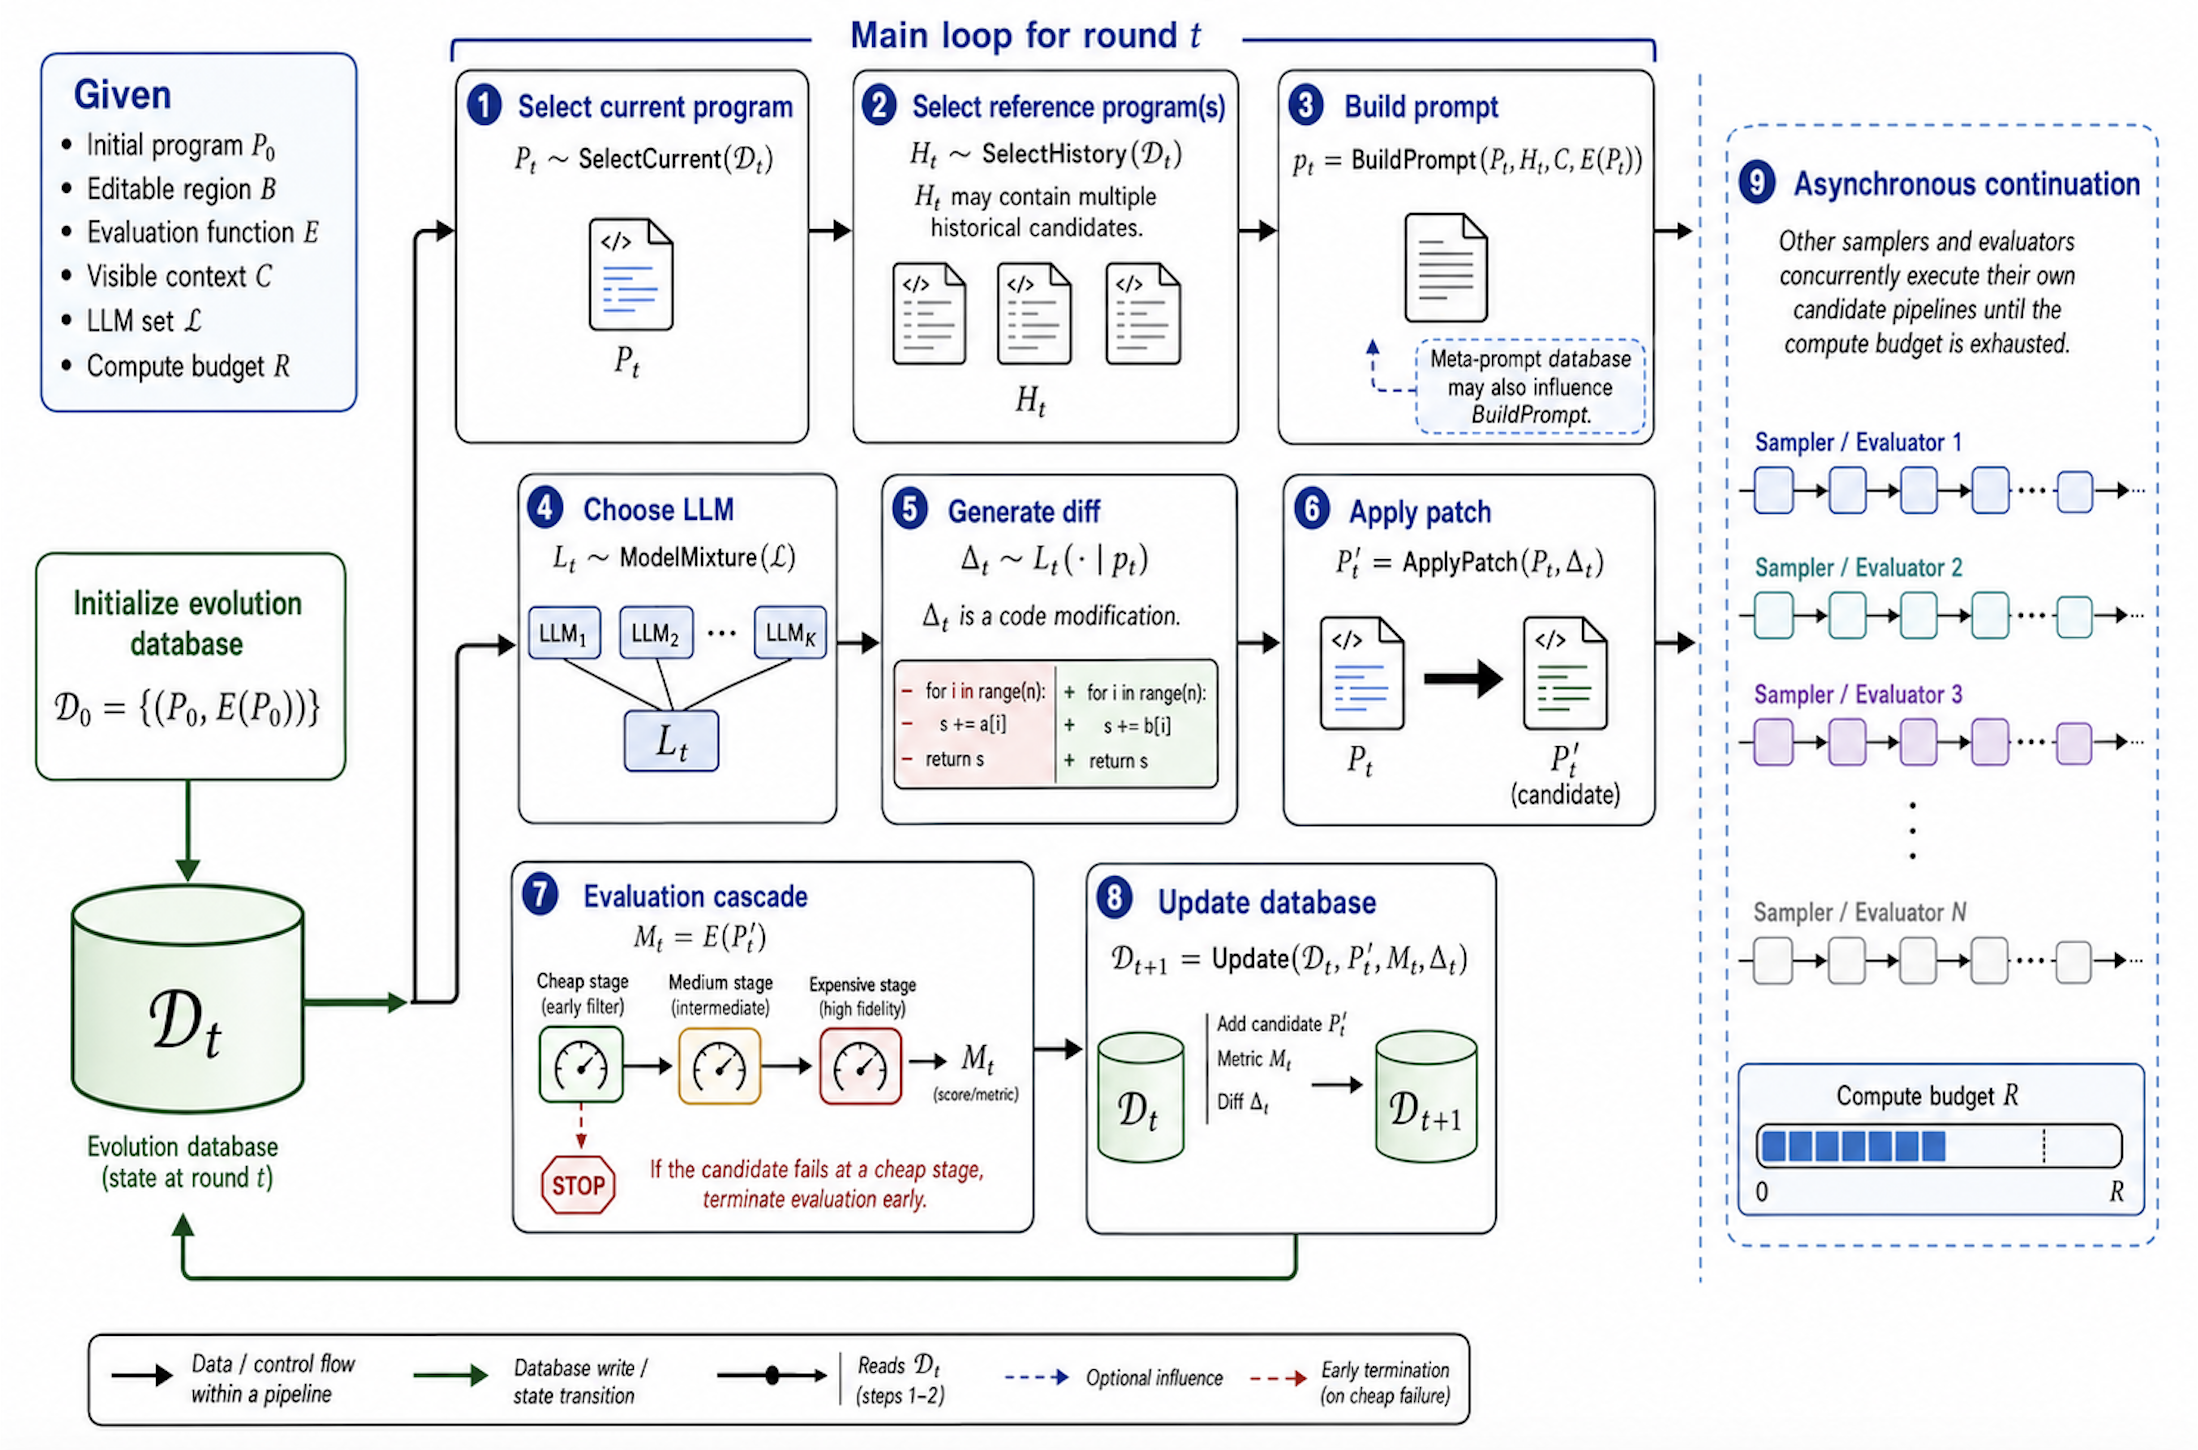
AlphaEvolve 面向能够被程序自动评分的问题。对候选程序 \(P\),评估函数返回多个指标:
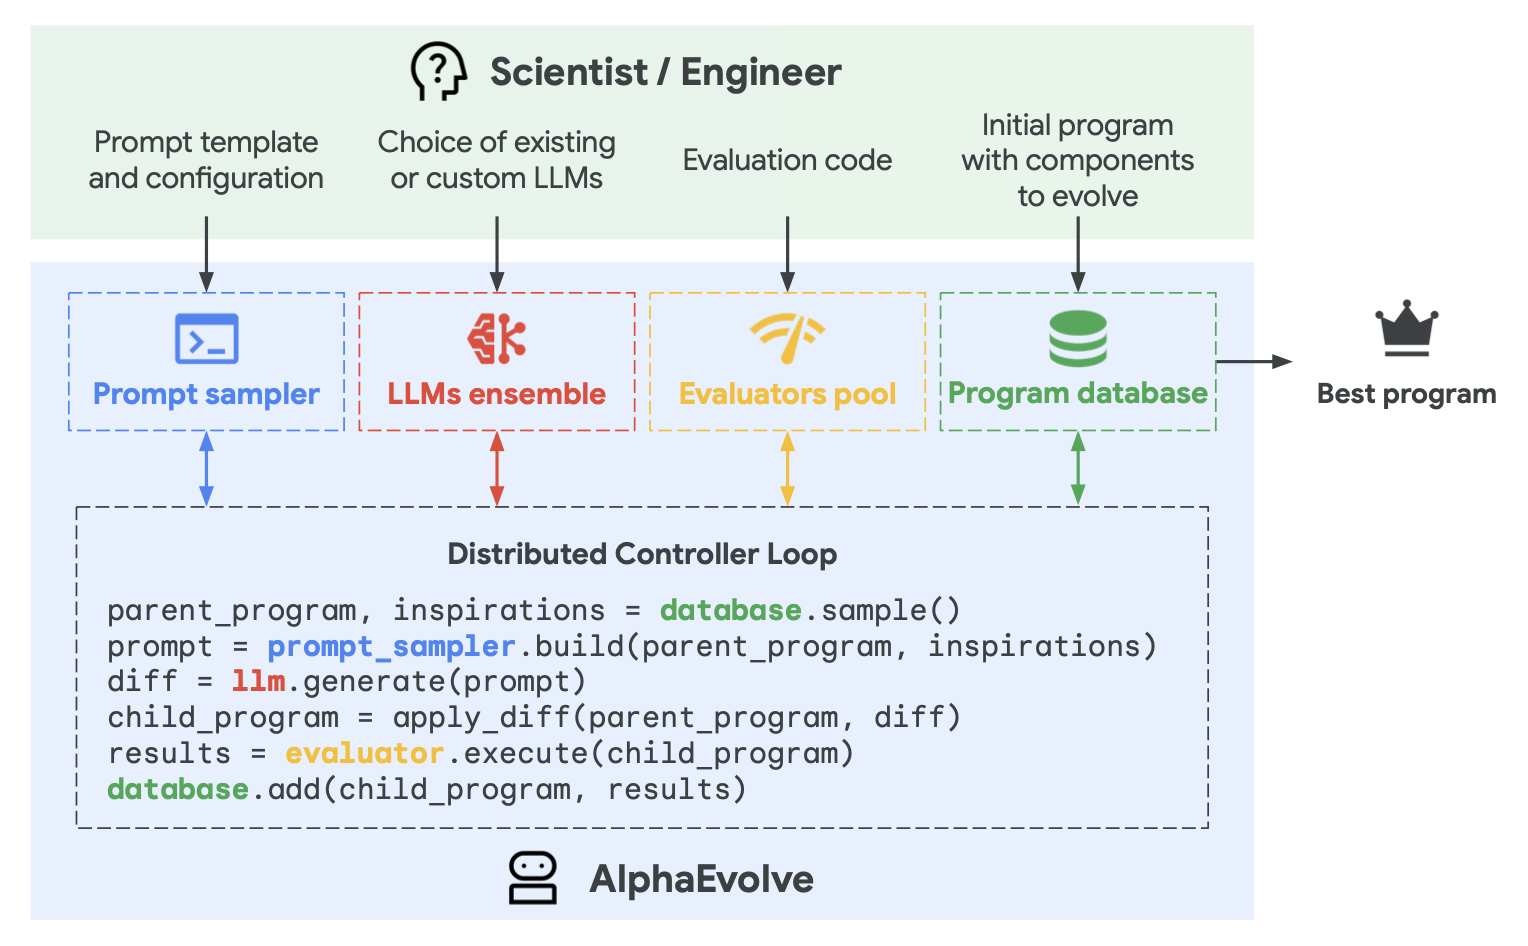
系统由以下组件构成:任务规范、提示词采样器、LLM 集成、补丁应用器、评估器和演化数据库。
任务规范与演化块
用户提供一个把候选程序映射到指标字典的评估函数:
def evaluate(eval_inputs) -> dict[str, float]:
    ...
    return metrics
同时用特殊标记指定可修改区域:
# EVOLVE-BLOCK-START
def optimizer():
    ...

def loss_function():
    ...
# EVOLVE-BLOCK-END
标记之外的代码保持不变,构成固定骨架。相比只演化单个函数的 FunSearch,AlphaEvolve 可以同时修改函数、类、配置甚至完整算法组件。
丰富的提示词上下文
AlphaEvolve 的提示词可以抽象为
除了历史候选与多项分数,还能包含执行输出、自然语言反馈、问题定义、数学公式、工程约束、论文、API 文档、失败方案和硬件信息。这让模型不仅从过往解法学习,也能使用显式领域知识。
基于补丁的演化
对于几百或几千行的代码库,让 LLM 每次重写整个文件会引入很多问题:正确代码可能被误删,无关部分可能变化,token 成本更高,也难以判断是哪一处修改带来了提升。长期迭代还容易发生“代码漂移”。
因此 AlphaEvolve 让模型输出局部 diff:
<<<<<<< SEARCH
return optax.adam(learning_rate)
=======
return optax.adamw(
    learning_rate,
    weight_decay=1e-4,
)
>>>>>>> REPLACE
SEARCH 必须精确匹配当前代码,REPLACE 则给出新实现。补丁机制让修改局部、可追踪,并保留整体软件结构。
LLM 集成与评估级联
AlphaEvolve 可以混合多个模型或采样配置:
不同模型带来不同的探索行为,有助于提高候选多样性。
大规模演化不能对每个候选都执行最昂贵的测试,因此采用逐渐增加成本的评估级联:
阶段 0:语法与导入检查
阶段 1:小规模输入测试
阶段 2:有限随机种子
阶段 3:完整评估集
阶段 4:大规模并行实验
阶段 5:严格正确性验证
若第 \(k\) 阶段的成本为 \(c_k\)、通过阈值为 \(\tau_k\),只有满足
的候选才能进入下一阶段。低质量程序被尽早淘汰,昂贵计算只留给有希望的方案。
元提示词演化
AlphaEvolve 还可以演化用于生成程序的提示词本身。系统同时维护两个档案:
于是被搜索的不只是解,也包括“发现解的方法”。
Escher-Loop

AlphaEvolve 会持续修改任务代码,但控制搜索过程的优化规则大体固定。如果真正限制性能的是搜索方法本身,而不是当前候选程序,那么只继续修改候选解终究会遇到瓶颈。
Escher-Loop 的核心观点是:智能的关键不在于静态掌握某项任务,而在于同时优化任务解法与优化器自身的动态能力。

系统因此同时演化任务解种群与优化器种群,这一过程称为互演化。优化器根据绝对评价分数推动任务解演化;反过来,优化器的优劣则由它能否产生更好的任务解来衡量。
记任务智能体种群和优化器种群分别为
采样到的优化器 \(o_i\) 根据一组已有任务解及分数,生成新候选:
动态基准
为了公平比较优化器,每一轮先采样一组优化器
再从任务种群采样完全相同的上下文
所有参赛优化器都接收同一个 \(C_J\),分别生成新解
由固定评估器 \(f\) 打分
并把新解加入任务种群。
任意两个优化器生成的结果可以比较为胜、平或负:
论文使用 Elo 评分衡量优化器的相对能力。若当前 Elo 分别为 \(s_u^o\) 和 \(s_v^o\),优化器 \(u\) 胜过 \(v\) 的期望得分为
实际比赛结果到来后更新:
这样,能在相同上下文下生成更好任务解的优化器会获得更高分,也更可能在后续演化中被选择。任务解与优化器由此形成闭环、自指式的共同进化。

参考文献
[1] Romera-Paredes, B., Barekatain, M., Novikov, A. et al. Mathematical discoveries from program search with large language models. Nature 625, 468–475 (2024). https://doi.org/10.1038/s41586-023-06924-6
[2] Novikov, A., Vu, N., Eisenberger, M. et al. AlphaEvolve: A coding agent for scientific and algorithmic discovery. arXiv:2506.13131. https://doi.org/10.48550/arXiv.2506.13131
[3] Liu, Z., Guo, X., Wei, X. et al. Escher-Loop: Mutual Evolution by Closed-Loop Self-Referential Optimization. arXiv:2604.23472. https://doi.org/10.48550/arXiv.2604.23472
评论