我的强化学习奇妙冒险:从 PPO 到 GRPO
本文是英文原文的中文译写版。核心公式、算法关系与实现要点保持一致,较长的工程代码被压缩为关键片段;完整实现可在文中的开源仓库查看。
预备知识
策略梯度方法
我们希望学习一个策略 \(\pi_\theta(a\mid s)\),它表示智能体在状态 \(s\) 下选择动作 \(a\) 的概率。策略由神经网络参数 \(\theta\) 控制,因此目标是调整 \(\theta\),让策略获得更高的期望奖励。
假设智能体按照 \(\pi_\theta\) 采样动作,得到轨迹
其折扣累计奖励为
最直接的优化目标是
问题在于,奖励通常不是参数 \(\theta\) 的可微函数。策略梯度的关键并不是对奖励本身求导,而是提高“采到高奖励轨迹”的概率。
一条轨迹的概率为
其中环境转移概率 \(P\) 不依赖 \(\theta\)。利用对数导数技巧:
时刻 \(t\) 的动作只应为它之后的奖励负责,因此用动作价值函数
替代整条轨迹的回报,可得
直接使用 \(Q\) 的方差很大。一个动作得到 10 分看似不错,但如果该状态下的平均分是 20,它其实表现很差。因此更合理的量是优势函数:
最终得到常用的策略梯度估计:
它的直觉非常直接:
- \(\hat A_t>0\) 时,提高当前动作的对数概率;
- \(\hat A_t<0\) 时,降低当前动作的对数概率;
- 优势绝对值越大,更新幅度越大。
信赖域策略优化
如果使用同一批采样数据时,新策略一次偏离旧策略太远,策略梯度更新会变得不稳定。TRPO 在最大化代理目标的同时,用 KL 散度限制更新大小:
满足
也可以把约束改写为带 KL 惩罚的无约束目标,但惩罚系数 \(\beta\) 很难在不同任务间统一选择。
近端策略优化(PPO)
记新旧策略对同一动作的概率比为
保守策略迭代目标为
直接最大化它仍可能让策略变化过大。PPO 使用裁剪代理目标:
裁剪的作用是:当概率比继续朝“有利”方向变化、但已经超过可信范围时,不再给予额外收益,从而抑制过大的策略更新。
完整 PPO 目标通常还包含价值函数损失和熵奖励:
价值函数用于估计优势。广义优势估计(GAE)写作
其中 TD 误差为
\(\lambda\) 控制偏差与方差之间的折中。
组相对策略优化(GRPO)
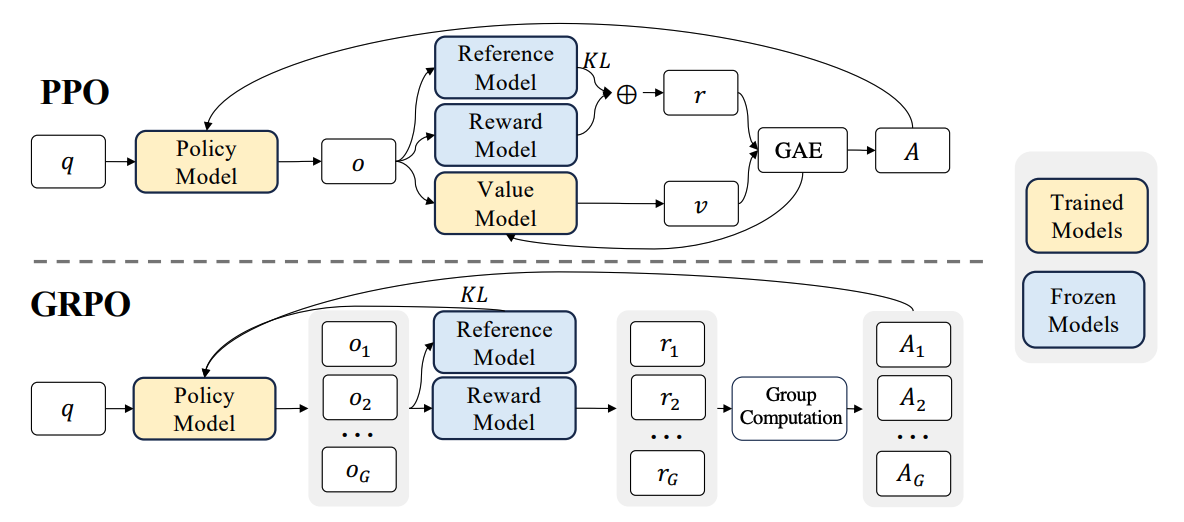
PPO 被广泛用于大语言模型的强化学习微调。对问题 \(q\) 和旧策略生成的输出 \(o\),其核心仍是逐 token 的裁剪代理目标。
标准 PPO 需要同时训练策略模型和价值模型。为了防止策略过度优化奖励模型,通常还会在每个 token 的奖励中加入相对于参考模型的 KL 惩罚:
这里的 KL 与 TRPO 不同:TRPO 约束当前策略和旧策略之间的变化;这里则限制当前策略偏离固定参考策略的程度。
价值模型通常和策略模型规模相近,会带来显著的显存与计算开销。更麻烦的是,在数学推理和代码任务中,奖励往往只在最终答案处给出,很难训练一个能够为每个 token 准确估值的价值函数。
GRPO 因此取消了独立价值模型。对每个问题 \(q\),先从旧策略采样一组输出
然后只依据组内奖励的相对大小计算优势。常见做法是标准化每条输出的最终奖励:
这个标量优势会广播到该输出的所有有效 token。GRPO 的策略目标仍沿用 PPO 的概率比裁剪,并额外加入相对于参考策略的 KL 正则:
DeepSeekMath 使用的逐样本无偏 KL 估计为
它始终非负。
代码实现
完整实现已开源在 bizzare-rl,实验在单张 NVIDIA H800、CUDA 12.4 环境下运行。代码主要参考:
PPO
GAE 具有递归形式
因此可以从序列末尾向前计算:
def compute_gae_advantage(rewards, values, response_mask, gamma, lam):
    with torch.no_grad():
        last_gae = 0
        reversed_advantages = []
        T = rewards.shape[-1]

        for t in reversed(range(T)):
            next_value = values[:, t + 1] if t < T - 1 else 0.0
            delta = rewards[:, t] + gamma * next_value - values[:, t]
            last_gae = delta + gamma * lam * last_gae
            reversed_advantages.append(last_gae)

        advantages = torch.stack(reversed_advantages[::-1], dim=1)
        returns = advantages + values
        advantages = masked_whiten(advantages, response_mask)
    return advantages, returns
在 NLP 训练中,一个 batch 通常由提示词 token、回复 token 和 padding 组成。策略梯度只应作用于回复部分,因此均值、方差和损失聚合都必须使用 response_mask。
实践中还常使用 Dual-Clip。普通裁剪能很好地限制正优势样本,但当优势为负且概率比异常大时,未裁剪项仍可能造成巨大的损失贡献。Dual-Clip 为负优势再加一道下界:
ratio = torch.exp(log_prob - old_log_prob)
loss_unclipped = -advantages * ratio
loss_clipped = -advantages * torch.clamp(
    ratio, 1 - cliprange_low, 1 + cliprange_high
)
ppo_loss = torch.maximum(loss_unclipped, loss_clipped)

dual_clip_loss = torch.minimum(-advantages * dual_clip_c, ppo_loss)
policy_loss = torch.where(advantages < 0, dual_clip_loss, ppo_loss)
policy_loss = masked_mean(policy_loss, response_mask)
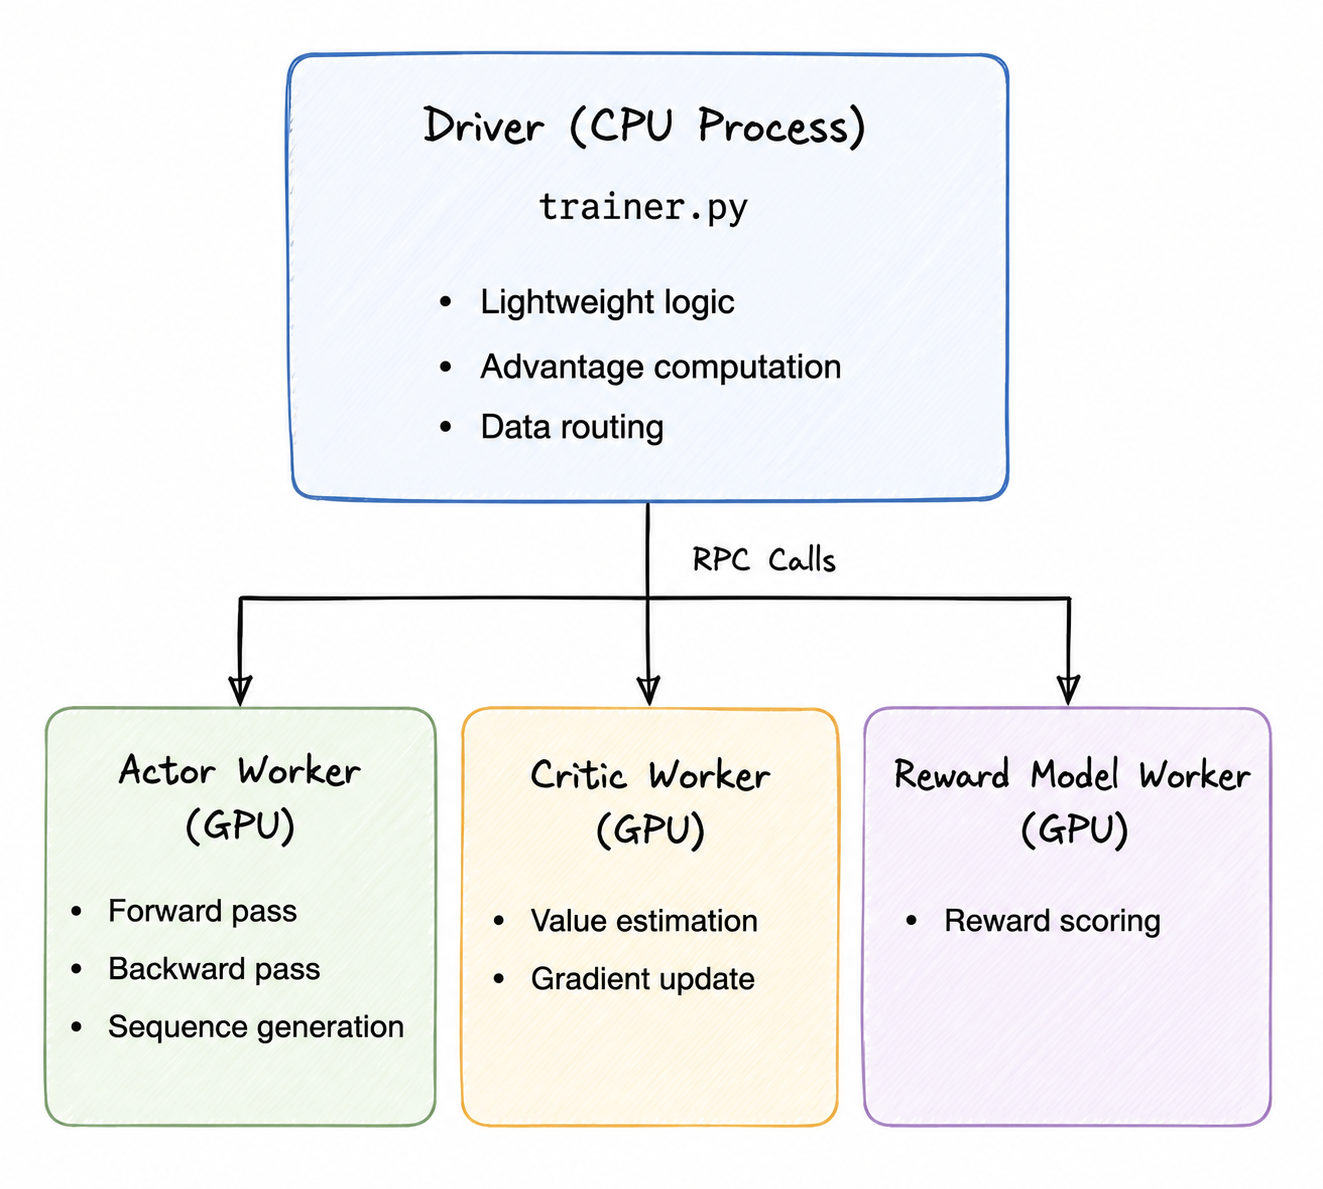
价值函数也可围绕旧预测做裁剪,再取裁剪前后平方误差的较大值;熵奖励则直接由策略 logits 计算。一个最小化的 PPO 训练循环包含:
- 策略模型生成回复;
- 奖励模型打分;
- 参考策略计算 KL 惩罚;
- 价值模型预测每个 token 的价值;
- 使用 GAE 计算优势;
- 更新价值模型;
- 使用裁剪目标更新策略模型。
GRPO
GRPO 的关键变化是按问题分组,并在组内标准化最终奖励:
def compute_grpo_outcome_advantage(rewards, response_mask, group_ids, eps=1e-6):
    scores = rewards.sum(dim=-1)

    with torch.no_grad():
        for group_id in np.unique(group_ids):
            mask = group_ids == group_id
            group_scores = scores[mask]
            mean = group_scores.mean()
            std = group_scores.std() if len(group_scores) > 1 else 1.0
            scores[mask] = (group_scores - mean) / (std + eps)

        advantages = scores.unsqueeze(-1) * response_mask
    return advantages, advantages
策略损失与 PPO 基本相同。训练循环不再计算 critic value,而是为每个提示词生成多条回复、计算组内相对优势,然后直接更新 actor:
- 为每个 prompt 分配组标识;
- 从旧策略采样 \(G\) 条回复;
- 计算奖励与参考模型 KL;
- 按组标准化奖励,得到每条回复的优势;
- 用 PPO 式裁剪目标更新策略模型。
GRPO 用更多同题采样换掉了价值模型,尤其适合奖励集中在最终结果、且组内答案容易比较的推理任务。
参考文献
[1] John Schulman, Filip Wolski, Prafulla Dhariwal, Alec Radford, Oleg Klimov. (2017). Proximal Policy Optimization Algorithms.
[2] Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Mingchuan Zhang, Y. K. Li, Y. Wu, Daya Guo. (2024). DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models.
评论