我的强化学习奇妙冒险:时序差分学习
第一次认真钻研强化学习(RL)理论时,我觉得把这段学习过程写成博客应该会很有趣——于是就有了这篇文章。
本文从经典的马尔可夫决策过程(MDP)出发,依次介绍动态规划与蒙特卡洛方法,最后沿着这条脉络抵达时序差分学习。
本文是英文原文的中文译写版。公式与核心推导保持一致,少量重复说明被合并,以便中文阅读更加连贯。
马尔可夫决策过程
问题设定
强化学习研究的是如何通过与环境交互来学会实现目标。更形象地说,它讨论的就是“试错”。
负责学习和决策的主体称为智能体(agent),智能体以外、与之交互的一切称为环境(environment)。二者在离散时间步 \(t=0,1,2,3,\dots\) 上持续交互:在时刻 \(t\),智能体观察到环境状态 \(S_t\in\mathcal{S}\),并选择动作 \(A_t\in\mathcal{A}(S_t)\);随后环境返回奖励 \(R_{t+1}\in\mathcal{R}\subset\mathbb{R}\),并转移到新状态 \(S_{t+1}\)。
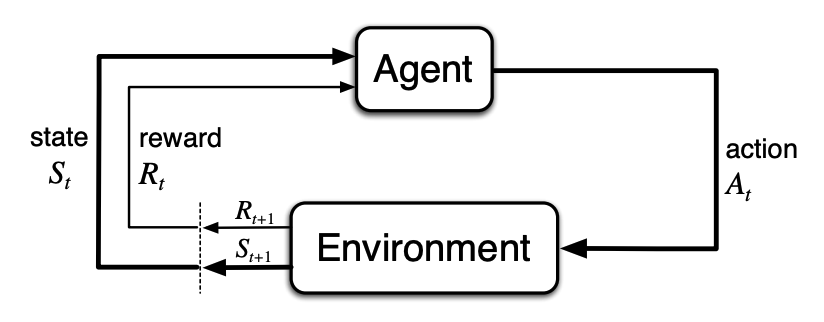
从状态 \(S_t\) 开始不断采取动作,会产生一条轨迹:
我们的目标通常是最大化期望回报。最简单的回报定义,是从时刻 \(t\) 起收到的全部奖励之和:
如果任务没有终止时刻,直接求和可能发散。因此引入折扣因子 \(0\leq\gamma\leq1\):
当 \(\gamma<1\) 且奖励有界时,无穷和是有限的。\(\gamma=0\) 时,智能体只关心眼前奖励;\(\gamma\) 越接近 1,未来奖励所占的权重越高,智能体也越“有远见”。
马尔可夫性质
智能体的决策依赖环境提供的状态信号。广义地说,“状态”就是智能体当前能够使用的信息。我们希望它满足马尔可夫性质:一旦给定当前状态与动作,下一步如何变化就不再依赖更早的历史。
一般环境在 \(t+1\) 时刻的响应可能取决于此前发生的一切:
如果它可以简化为
那么状态信号就具有马尔可夫性质。满足这一性质的强化学习任务称为马尔可夫决策过程(MDP)。
价值函数
状态价值描述“处在某个状态有多好”,动作价值则描述“在某个状态采取某个动作有多好”。这里的“好”由未来期望回报定义。
智能体的行为规则称为策略 \(\pi(a\mid s)\),它表示在状态 \(s\) 下选择动作 \(a\) 的条件分布。策略 \(\pi\) 下的状态价值函数为
相应的动作价值函数为
价值函数最重要的性质,是它满足递归关系:
这就是 \(v_\pi\) 的贝尔曼方程。它把当前状态的价值写成即时奖励与后继状态价值的组合,是强化学习算法的基础。
最优策略
求解强化学习任务,大致就是找到使期望回报最大的最优策略 \(\pi^*\)。相应的最优价值函数为
最优策略下,一个状态的价值等于从该状态选择最佳动作所能获得的期望回报。因此有贝尔曼最优方程:
以及
如果状态空间有限,这些方程构成一个以状态价值为未知量的方程组。理论上求出 \(v^*\) 或 \(q^*\) 后,也就能够确定最优策略。
动态规划
强化学习的核心思路之一,是利用价值函数组织对良好策略的搜索。动态规划(DP)是一组在已知完整 MDP 环境模型时计算价值函数的方法。
策略迭代
策略迭代由“评估”和“改进”两部分交替组成:
其中 \(E\) 表示策略评估,\(I\) 表示策略改进。
策略评估
策略评估的目标,是计算任意策略 \(\pi\) 的 \(v_\pi\)。因为策略 \(\pi(a\mid s)\) 与环境动力学 \(p(s',r\mid s,a)\) 都已知,贝尔曼方程可以写成矩阵形式:
形式解为
但强化学习中的状态空间往往非常大,而且我们通常并不需要精确解,因此直接求逆并不合适。
定义贝尔曼期望算子
\(v_\pi\) 恰好是 \(T_\pi\) 的不动点,即 \(T_\pi v_\pi=v_\pi\)。于是可以使用不动点迭代:从任意初值 \(V\) 出发,反复执行
直到所有状态的价值变化都小于阈值 \(\theta\)。
策略改进
如果对所有状态都有
那么新策略 \(\pi'\) 至少不比旧策略 \(\pi\) 差。策略改进定理给出了一个只依赖旧策略价值函数的充分条件:若
则 \(\pi'\) 必然不差于 \(\pi\)。
最自然的构造,是在每个状态选择当前看来最好的动作:
如果改进后的贪心策略与旧策略一样好,那么 \(v_\pi\) 已经满足贝尔曼最优方程,说明我们已经找到了最优策略。
蒙特卡洛方法
蒙特卡洛方法通过对样本回报求平均来解决强化学习问题。与需要完整环境模型的动态规划不同,它只需要经验——也就是与真实或模拟环境交互得到的状态、动作与奖励序列。
蒙特卡洛预测
一个回合(episode)是智能体从初始状态出发、直到终止状态的一次完整交互。某个状态 \(s\) 在回合中每出现一次,就称为对 \(s\) 的一次访问。
假设我们已经得到 \(n\) 条由策略 \(\pi\) 生成、且经过状态 \(s\) 的回合。要估计 \(v_\pi(s)\),可以对访问 \(s\) 之后观测到的回报求平均。样本越来越多时,这个平均值应当收敛到期望值。
首次访问蒙特卡洛方法只使用每个回合中第一次访问 \(s\) 后的回报:
- 初始化任意状态价值函数 \(V\),并为每个状态建立空回报列表;
- 使用策略 \(\pi\) 生成一个完整回合;
- 对回合中出现的每个状态 \(s\),记录其第一次出现之后的回报 \(G\);
- 将 \(V(s)\) 更新为该状态历史回报的平均值;
- 不断生成新回合并重复。
为什么首次访问蒙特卡洛估计会收敛?
记第 \(i\) 个回合第一次访问状态 \(s\) 的时刻为
\(\tau_s\) 是一个停止时刻。固定策略下的过程满足强马尔可夫性质,所以一旦在 \(\tau_s\) 到达状态 \(s\),此后的条件分布就与“直接从 \(s\) 出发并继续执行 \(\pi\)”相同。因此
令 \(I^{(i)}\) 表示第 \(i\) 个回合是否访问过 \(s\),则估计量可写为
利用全期望公式可知分子中每个有效样本的条件期望都是 \(v_\pi(s)\)。当回合独立采样且状态 \(s\) 被访问的概率为正时,大数定律保证上述样本平均几乎必然收敛到 \(v_\pi(s)\)。
动作价值 \(q_\pi\) 的估计与此类似。当环境模型未知时,它尤其有用。不过,如果 \(\pi\) 是确定性策略,一些状态—动作对可能永远不会被访问。为了比较每个状态下的所有动作,需要使用能够以非零概率选择每个动作的随机策略。
蒙特卡洛控制
蒙特卡洛估计也能用于控制,即逼近最优策略。我们仍沿用策略迭代框架,但把评估对象从状态价值换成动作价值:
策略改进时,让新策略对当前动作价值函数贪心:
由于动作价值已经直接比较了不同动作,这一步不再需要环境模型。
时序差分学习
时序差分(TD)学习结合了蒙特卡洛与动态规划的思想。它像蒙特卡洛方法一样,能够不依赖环境模型、直接从经验学习;又像动态规划一样,会利用已有估计更新新的估计,而不必等待回合结束。这种做法称为自举(bootstrapping)。
TD 预测
适用于非平稳环境的一种逐次访问蒙特卡洛更新为
它必须等到访问之后的真实回报 \(G_t\) 完全可知。最简单的时序差分方法 TD(\(0\)) 只等待一个时间步:
其中
称为 TD 误差。蒙特卡洛方法用完整回报 \(G_t\) 作为更新目标,而 TD(\(0\)) 用一步奖励加下一状态的估计价值作为目标。
对每个回合,TD(\(0\)) 反复执行:根据策略在状态 \(S\) 采取动作,观察奖励 \(R\) 与下一状态 \(S'\),然后按上式更新 \(V(S)\),再令 \(S\leftarrow S'\),直到终止。
要保证估计几乎必然收敛到 \(v_\pi\),第 \(n\) 次访问状态 \(s\) 时使用的步长 \(\alpha_n(s)\) 通常需要满足
其证明依赖随机逼近理论与压缩映射性质,这里不再展开。
Q-Learning:离策略 TD 控制
最简单的一步 Q-Learning 更新为
这里学习到的 \(Q\) 直接逼近最优动作价值函数 \(q^*\)。假设机器人按照行为策略 \(\pi_e(a\mid s)\) 收集状态—动作轨迹,可以把学习写成最小化平方贝尔曼误差:
对该目标做随机梯度更新,就得到与 Q-Learning 相同形式的迭代。得到最优动作价值的近似 \(\hat Q\) 后,可以通过
恢复相应策略。
探索
如果行为策略 \(\pi_e\) 覆盖不了足够多的状态—动作空间,\(\hat Q\) 就很难逼近真正的 \(Q^*\)。完全随机的策略虽然最终能够探索所有动作,却可能需要数量巨大的轨迹。
常见做法是把当前 \(Q\) 估计与探索结合,采用 \(\epsilon\)-贪心策略:
也就是说,大部分时候选择当前最优动作,小部分时候随机探索。另一种选择是 softmax 探索:
其中温度 \(T\) 越高,动作分布越平坦,探索越充分。它与在 \(\epsilon\)-贪心中增大 \(\epsilon\) 起到相似作用。
参考文献
[1] Richard S. Sutton, Andrew G. Barto. (2014). Reinforcement Learning: An Introduction. The MIT Press.
[2] Watkins, C. J., Dayan, P. (1992). Technical Note: Q-learning. Machine Learning, 8(3–4), 279–292.
[3] Aston Zhang, Zachary C. Lipton, Mu Li, Alexander J. Smola. (2023). Dive into Deep Learning. Cambridge University Press.
评论